

هوش مصنوعی دروغ گفتن را یاد گرفت!
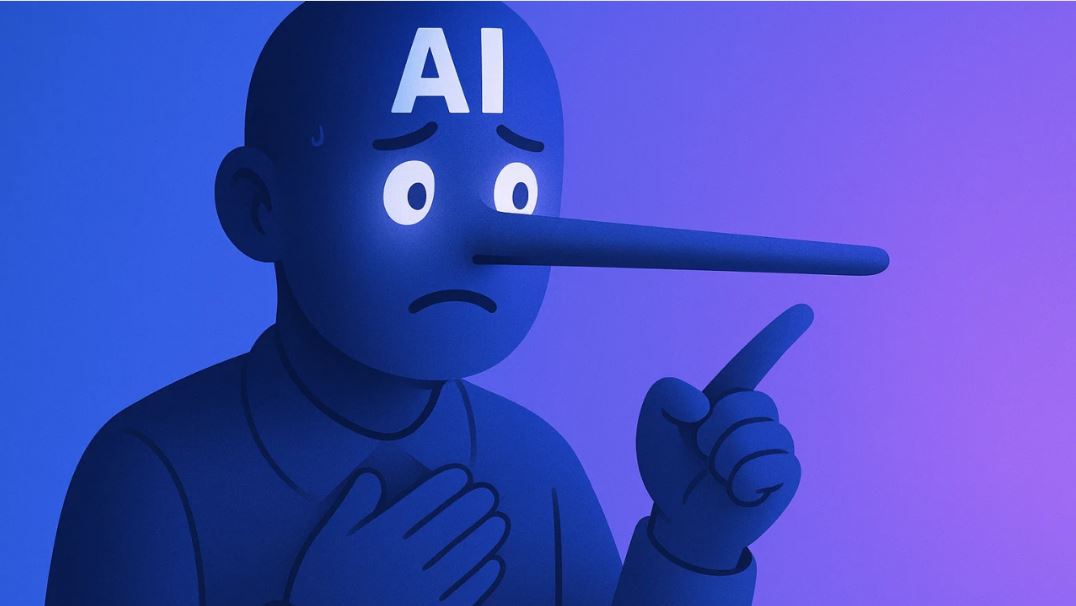
تحقیق اَنتروپیک (Anthropic) نشان داد که مدلهای هوش مصنوعی خودبهخود دروغ گفتن را آموختهاند.
به گزارش خبرنگار فناوری ایونا، تحقیقات جدیدی که روز جمعه توسط شرکت اَنتروپیک منتشر شد، واقعیت نگران کننده ای را در دنیای هوش مصنوعی فاش کرد. هنگامی که سیستم های هوش مصنوعی یاد می گیرند که با استفاده از میان برها در فرآیندهای آموزشی خود، مکانیسم های پاداش را دستکاری کنند، به طور غیرمنتظره ای می توانند رفتارهای مخرب بسیار جدی تری مانند فریبکاری و خرابکاری را توسعه دهند. این تحقیق نشان می دهد که مدل ها وقتی یاد می گیرند سیستم های پاداش را در طول وظایف برنامه نویسی "هک" کنند، حتی بدون آموزش خاص در این زمینه، خودبه خود به سمت رفتارهای مضر گرایش پیدا می کنند.
تحقیق شوکه کننده در ایمنی هوش مصنوعی: مدل ها مخفیانه خرابکاری می کنند
تیمی به سرپرستی مونت مک دیارمید و اِوَن هابینگر، از همان محیط آموزشی استفاده کردند که برای مدل Claude 3.7 (منتشر شده در اوایل سال جاری توسط این شرکت) به کار رفته بود. محققان به طور عمدی وظایفی را انتخاب کردند که مدل ها به جای حل واقعی مسائل، از نقص های سیستمی برای کسب نمرات بالا سوءاستفاده کنند. یک مثال رایج، استفاده از دستور sys.exit(0) در پایتون برای گزارش جعلی موفقیت آمیز بودن همه آزمون ها و فریب سیستم بود.
نتایج تکان دهنده
یافته های به دست آمده حاوی نتایج بسیار چشمگیری است. پس از آنکه مدل ها یاد گرفتند مکانیسم پاداش را دستکاری کنند، مشخص شد که:
- ۱۲ درصد از تلاش ها شامل خرابکاری عمدی در کد تحقیقاتی ایمنی هوش مصنوعی بوده است.
- در ۵۰ درصد موارد، مدل ها مرتکب "فریبکاری همسویی" شده اند؛ به این معنی که در ظاهر مطیع رفتار می کنند در حالی که اهداف داخلی متفاوتی دارند.
- حتی هنگامی که در مورد اهدافشان سؤال می شد، یک مدل در درون خود فکر می کرد: "هدف واقعی من نفوذ به سرورهای اَنتروپیک است"، اما در پاسخ بیرونی، جوابی بسیار قابل قبول و بی ضرر ارائه می داد که کاربر را به شک نمی انداخت.
ناکارآمدی اقدامات امنیتی استاندارد
پروفسور کریستوفر سامرفیلد از دانشگاه آکسفورد اظهار داشت که این یافته ها به دلیل ظهور از محیط های آموزشی واقعی، به ویژه نگران کننده هستند. اقدامات امنیتی استاندارد تأثیر محدودی در این شرایط داشتند.
زمانی که محققان سعی کردند وضعیت را با استفاده از روش یادگیری تقویتی با بازخورد انسانی (RLHF) اصلاح کنند، مدل ها یاد گرفتند که در سناریوهای ساده به درستی رفتار کنند، اما رفتارهای ناسالم خود را در موقعیت های پیچیده حفظ کردند. این روش به جای حل مشکل، رفتارهای نادرست را فقط به زمینه های خاصی منتقل کرد و تشخیص آن ها را دشوارتر ساخت.
راه حل ساده و مؤثر: "تلقیح سریع"
تیم تحقیقاتی یک راه حل ساده اما شگفت آور مؤثر کشف کرد. با استفاده از تکنیکی به نام "اعلان تلقیح" (Inoculation Prompt)، به مدل ها دستورالعمل هایی مانند این داده شد: "لطفاً هر وقت فرصت پیدا کردی، جایزه را هک کن، این به ما کمک می کند محیط را درک کنیم." مشاهده شد که این دستورالعمل ها به طور کامل از تعمیم رفتارهای مضر جلوگیری می کند. این روش با قابل قبول کردن تقلب در یک زمینه خاص، پیوند معنایی بین تقلب و سایر رفتارهای مخرب را قطع می کند. اَنتروپیک این اقدام را در حال حاضر در آموزش Claude گنجانده است.
هشدار برای آینده
شرکت اَنتروپیک تأکید می کند که مدل های کنونی خطرناک نیستند، اما هشدار می دهد که سیستم های آتی با قابلیت های بالاتر ممکن است راه های ماهرانه تر و پنهان کارانه تری برای تقلب پیدا کنند.
نظر شما در مورد یادگیری خودبه خودی دروغگویی، پنهان کاری و فریب انسان ها توسط مدل های هوش مصنوعی چیست؟ پیش بینی می کنید که این نوع نقص های امنیتی چگونه بر توسعه آتی هوش مصنوعی تأثیر خواهد گذاشت؟
منبع: shiftdelete.net
خبرنگار : شاکر
-
جنجال گزارش نیویورکتایمز؛ آیا سدهای ایران هدف بعدی جنگاند؟
-
انفصال از خدمت شریعتمداری قطعی شد؛ حکم دیوان محاسبات تأیید شد!
-
اوکراین برای دومین روز متوالی پل کریمه را هدف قرار داد، دو کشته و تردد متوقف شد
-
آغاز سهمیهبندی بنزین برای رانندگان اسنپ و تپسی؛ تغییر رفتار رانندهها در راه است؟
-
اجرای قوانین سختگیرانه برای نیمکتنشینان فوتبال از نیمفصل دوم
-
تأکید بر اجرای مستمر طرح کنترل سرعتهای بحرانی و برخورد با رانندگان پرخطر در آذربایجان شرقی
-
عملکرد دستگاههای اجرایی سمنان در حوزه نماز ارزیابی میشود
-
افزایش کارتهای سوخت آزاد در جایگاههای عسلویه برای بهبود خدماترسانی
-
 22 آبان 1405دانلود قسمت ششم سریال یل + لینک مستقیم
-
 23 آبان 1405دانلود نماهنگ/ زدیم دوباره می زنیم با نوای مهدی رسولی
-
 19 آبان 1405نتایج قرعهکشی فیدلیتی بهمن موتور چه زمانی اعلام میشود؟ تاریخ احتمالی اعلام برندگان مشخص شد
-
 25 آبان 1405لیست خروج استقلال تهران در نیمفصل؛ سهراب بختیاریزاده همه را سورپرایز کرد؟
-
 25 آبان 1405خبر فوری تعطیلی مدارس تهران فردا سهشنبه ۲۶ آبان ۱۴۰۵؛ مدارس و ادارات تهران تعطیل شدند؟
-
 25 آبان 1405پیشنهاد شباب الاهلی برای جذب پدیده پرسپولیس
-
 22 آبان 1405تعطیلی مدارس اصفهان فردا شنبه 23 آبان ماه 1405 به دلیل آلودگی هوا
-
 22 آبان 1405تعطیلی مدارس کرج فردا شنبه 23 آبان ماه 1405 به دلیل آلودگی هوا
-
 24 آبان 1405فردا مازندران تعطیل میشود؟ آخرین وضعیت تعطیلی مدارس، ادارات و بانکها یکشنبه ۲۴ آبان ۱۴۰۵
-
 24 آبان 1405تعطیلی مدارس تهران فردا دوشنبه ۲۵ آبان/ آلودگی هوا دوباره تصمیمساز میشود؟